Termini AI essenziali: ricorrenza opaca e altri concetti importanti per comprendere l’intelligenza artificiale.
Pubblicato il da Ignazio Aragona - Tecnologia
L’intelligenza artificiale sta riscrivendo il mondo e, allo stesso tempo, sta inventando un linguaggio completamente nuovo per descrivere come lo sta facendo. Partecipa a qualsiasi riunione, pitch o panel di prodotto di questi giorni e sentirai le persone gettare frasi come LLMs, RAG, RLHF – e, dalla settimana scorsa, termini come “ricorrenza opaca”, la tecnica di ragionamento nel nuovo modello Astra di OpenAI che ha messo in allerta i ricercatori sulla sicurezza dell’IA. Il vocabolario si muove abbastanza velocemente da far sentire un po’ insicure anche le persone molto intelligenti nel mondo tecnologico.
Questo glossario è il nostro tentativo di risolvere questo problema: definizioni in linguaggio semplice dei termini relativi all’IA che è probabile tu incontri, che tu stia costruendo con questa tecnologia, investendoci o semplicemente cercando di tenerti aggiornato leggendo TechCrunch o ascoltando podcast correlati. Lo aggiorniamo regolarmente mentre il settore si evolve, quindi consideralo un documento in evoluzione, proprio come i sistemi di IA che descrive.
L’intelligenza artificiale generale, o AGI, è un termine nebuloso. Ma generalmente si riferisce a un’intelligenza artificiale più capace della media umana in molti, se non nella maggior parte, dei compiti. Il CEO di OpenAI Sam Altman ha descritto una volta l’AGI come “equivalente a un essere umano mediano che potresti assumere come collega di lavoro”. Nel frattempo, la carta di principi di OpenAI definisce l’AGI come “sistemi altamente autonomi che superano gli esseri umani nella maggior parte del lavoro economicamente più prezioso”. La comprensione di Google DeepMind differisce leggermente da queste due definizioni; il laboratorio considera l’AGI come “IA almeno altrettanto capace degli esseri umani nella maggior parte dei compiti cognitivi.” Confuso? Niente paura – anche gli esperti all’avanguardia della ricerca sull’IA lo sono.
Un agente di intelligenza artificiale si riferisce a uno strumento che utilizza tecnologie AI per svolgere una serie di compiti al tuo posto – oltre a ciò che potrebbe fare un chatbot AI più basilare – come presentare spese, prenotare biglietti o un tavolo in un ristorante, o addirittura scrivere e mantenere il codice. Tuttavia, come abbiamo spiegato in precedenza, ci sono molte parti in movimento in questo spazio emergente, quindi “agente di intelligenza artificiale” potrebbe significare cose diverse per persone diverse. L’infrastruttura è ancora in fase di sviluppo per offrire le capacità previste. Ma il concetto di base implica un sistema autonomo che potrebbe attingere a più sistemi AI per eseguire compiti multistep.
Pensa agli endpoint API come “pulsanti” sul retro di un software che altri programmi possono premere per farlo funzionare. Gli sviluppatori utilizzano queste interfacce per creare integrazioni – ad esempio, permettendo a un’applicazione di estrarre dati da un’altra, o consentendo a un agente di intelligenza artificiale di controllare direttamente servizi di terze parti senza che un umano operi manualmente ciascuna interfaccia. La maggior parte dei dispositivi per la casa intelligente e delle piattaforme connesse ha questi pulsanti nascosti disponibili, anche se gli utenti normali non li vedono mai o interagiscono con essi. Man mano che gli agenti di intelligenza artificiale diventano più capaci, sono sempre più in grado di individuare e utilizzare questi endpoint da soli, aprendo potenti – e a volte inaspettate – possibilità di automazione.
Dato un quesito semplice, il cervello umano può rispondere senza neanche pensarci troppo – cose come “quale animale è più alto, una giraffa o un gatto?” Ma in molti casi, spesso serve carta e penna per trovare la risposta giusta perché ci sono passaggi intermedi. Ad esempio, se un contadino ha polli e mucche, e insieme hanno 40 teste e 120 gambe, potresti dover scrivere un’equazione semplice per trovare la risposta (20 polli e 20 mucche).
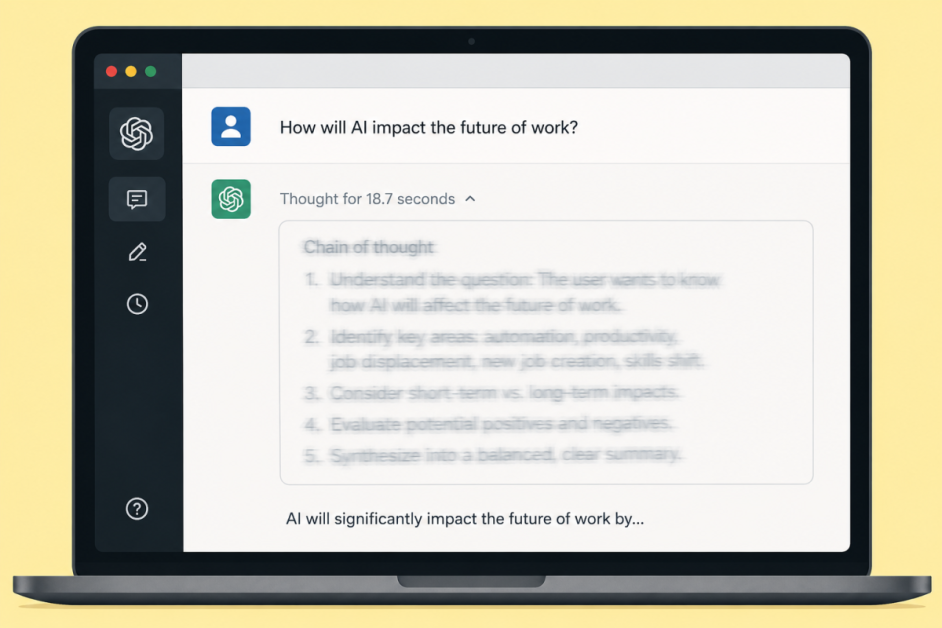
In un contesto di intelligenza artificiale, il ragionamento chain-of-thought per grandi modelli di linguaggio significa suddividere un problema in passaggi intermedi più piccoli per migliorare la qualità del risultato finale. Di solito ci vuole più tempo per ottenere una risposta, ma è più probabile che la risposta sia corretta, specialmente in un contesto logico o di codifica. I modelli di ragionamento sono sviluppati dai tradizionali grandi modelli di linguaggio e ottimizzati per il pensiero a catena grazie all’apprendimento per rinforzo.
Questo è un concetto più specifico di un “agente di intelligenza artificiale”, che significa un programma che può compiere azioni da solo, passo dopo passo, per completare un obiettivo. Un agente di codifica è una versione specializzata applicata allo sviluppo del software. Piuttosto che suggerire semplicemente codice per una revisione e incollarlo, un agente di codifica può scrivere, testare e debuggare autonomamente il codice, gestendo il tipo di lavoro iterativo, basato sul tentativo e sull’errore, che tipicamente occupa la giornata di un programmatore. Questi agenti possono operare su interi codici, individuando bug, eseguendo test e apportando correzioni con un minimo controllo umano. Immagina di assumere uno stagista molto veloce che non dorme mai e non perde mai la concentrazione – anche se, come con qualsiasi stagista, un umano deve comunque revisionare il lavoro.
Anche se in parte un termine multivalente, il calcolo si riferisce generalmente alla potenza computazionale vitale che consente ai modelli di IA di operare. Questo tipo di elaborazione alimenta l’industria dell’IA, conferendole la capacità di addestrare e dispiegare i suoi potenti modelli. Il termine è spesso una forma abbreviata dei tipi di hardware che forniscono la potenza computazionale – come GPU, CPU, TPU e altre forme di infrastruttura che costituiscono la base dell’industria moderna dell’IA.
Un sottoinsieme di apprendimento automatico che si auto-migliora in cui gli algoritmi di IA sono progettati con una struttura multi-strato di reti neurali artificiali (ANN). Ciò consente loro di stabilire correlazioni più complesse rispetto a sistemi di apprendimento automatico più semplici, come modelli lineari o alberi decisionali. La struttura degli algoritmi di apprendimento profondo trae ispirazione dai percorsi interconnessi dei neuroni nel cervello umano.
I modelli di intelligenza artificiale di apprendimento profondo sono in grado di identificare caratteristiche importanti nei dati da soli, anziché richiedere agli ingegneri umani di definire tali caratteristiche. La struttura supporta anche algoritmi in grado di imparare dagli errori e, attraverso un processo di ripetizione e aggiustamenti, migliorare le proprie uscite. Tuttavia, i sistemi di apprendimento profondo richiedono molti punti dati per fornire buoni risultati (milioni o più). Di solito richiedono anche più tempo per essere addestrati rispetto agli algoritmi di apprendimento automatico più semplici – quindi i costi di sviluppo tendono ad essere maggiori.
La diffusione è la tecnologia che è nel cuore di molti modelli di IA generativa per arte, musica e testo. Ispirati dalla fisica, i sistemi di diffusione “distruggono” gradualmente la struttura dei dati – ad esempio, foto, canzoni, ecc. – aggiungendo rumore finché non resta nulla. In fisica, la diffusione è spontanea ed irreversibile – lo zucchero diffuso nel caffè non può tornare alla forma di cubo. Ma i sistemi di diffusione nell’IA mirano a imparare una sorta di processo di “diffusione inversa” per ripristinare i dati distrutti, acquisendo la capacità di recuperare i dati dal rumore.
La distillazione è una tecnica utilizzata per estrarre conoscenza da un grande modello di IA con un modello “insegnante-studente”. Gli sviluppatori inviano richieste a un modello insegnante e registrano le uscite. A volte le risposte vengono confrontate con un insieme di dati per vedere quanto sono accurate. Queste uscite vengono poi utilizzate per addestrare il modello studente, che viene addestrato ad approssimare il comportamento dell’insegnante.
La distillazione può essere utilizzata per creare un modello più piccolo e più efficiente basato su un modello più grande con una perdita di distillazione minima. È probabile che OpenAI abbia sviluppato così GPT-4 Turbo, una versione più rapida di GPT-4.
Anche se tutte le aziende di IA utilizzano distillazione internamente, potrebbe essere stata utilizzata anche da alcune aziende di IA per raggiungere i modelli di punta. La distillazione da un concorrente viola generalmente i termini di servizio delle API e degli assistenti della chat di IA.
Si tratta del successivo addestramento di un modello di IA per ottimizzare le prestazioni per un compito o un’area più specifica rispetto a quanto fosse precedentemente il punto focale del suo addestramento – di solito alimentando nuovi dati specializzati (cioè orientati al compito). Molte startup di IA stanno prendendo come punto di partenza i grandi modelli di linguaggio per costruire un prodotto commerciale, ma stanno cercando di aumentare l’utilità per un settore o un compito di destinazione, integrando cicli di addestramento precedenti con un affinamento basato sulla conoscenza e sull’esperienza specifica del loro dominio.
[See: Grande modello di linguaggio [LLM])
Un GAN, o generative adversarial network, è un tipo di struttura di apprendimento automatico che sostiene alcuni importanti sviluppi nell’IA generativa quando si tratta di produrre dati realistici – compresi (ma non solo) strumenti deepfake. I GAN coinvolgono l’uso di una coppia di reti neurali, di cui una si basa sui dati di addestramento per generare un’uscita che viene passata all’altro modello per la valutazione.
I due modelli sono essenzialmente programmati per cercare di superarsi reciprocamente. Il generatore sta cercando di far passare la sua uscita oltre il discriminatore, mentre il discriminatore sta lavorando per individuare dati generati artificialmente. Questa gara strutturata può ottimizzare le uscite dell’IA per renderle più realistiche senza la necessità di ulteriori interventi umani. Anche se i GAN funzionano meglio per applicazioni più limitate (come la produzione di foto o video realistici), piuttosto che per l’IA di uso generale.
L’allucinazione è il termine preferito dall’industria dell’IA per descrivere i modelli di IA che inventano informazioni – letteralmente generando informazioni sbagliate. Ovviamente, è un grosso problema per la qualità dell’IA.
Le allucinazioni producono output GenAI che possono essere fuorvianti e potrebbero addirittura portare a rischi reali – con conseguenze potenzialmente pericolose (pensa a una query sulla salute che restituisce consigli medici dannosi). Si ritiene che il problema delle allucinazioni derivi da lacune nei dati di addestramento. Le allucinazioni contribuiscono a spingere verso modelli di IA sempre più specializzati e/o verticali – cioè IA specifiche per un determinato campo che richiedono competenze più concentrate – come modo per ridurre la probabilità di lacune di conoscenza e ridurre i rischi di disinformazione.
L’inferenza è il processo di esecuzione di un modello di IA. Implica il rilasciare un modello per fare previsioni o trarre conclusioni da dati precedentemente osservati. Per essere chiari, l’inferenza non può avvenire senza l’addestramento; un modello deve imparare i pattern in un insieme di dati prima che possa estrapolare efficacemente da questi dati di addestramento.
Molti tipi di hardware possono eseguire l’inferenza, dalle CPU degli smartphone alle potenti GPU agli acceleratori AI progettati su misura. Ma non tutti possono eseguire modelli allo stesso modo. Modelli molto grandi richiederebbero tanto tempo per fare previsioni, ad esempio, su un laptop rispetto a un server cloud con chip AI di alta gamma.
[See: Addestramento]
I grandi modelli di linguaggio, o LLM, sono i modelli di IA utilizzati da popolari assistenti di intelligenza artificiale, come ChatGPT, Claude, Gemini di Google, Llama AI di Meta, Copilot di Microsoft o Le Chat di Mistral. Quando chatti con un assistente di intelligenza artificiale, interagisci con un grande modello di linguaggio che elabora direttamente la tua richiesta o con l’aiuto di diversi strumenti disponibili, come la navigazione web o gli interpreti di codice.
I “token” sono i piccoli frammenti di testo – spesso parti di parole piuttosto che intere – in cui i modelli di linguaggio basati su IA suddividono il linguaggio prima di elaborarlo; sono approssimativamente analoghi a “parole” al fine di comprendere i carichi di lavoro dell’IA. Il “throughput” si riferisce a quanto può essere elaborato in un determinato periodo di tempo, quindi il “token throughput” è essenzialmente una misura di quanto lavoro di IA un sistema può gestire contemporaneamente. Un “token throughput” elevato è un obiettivo chiave per i team di infrastruttura di IA, poiché determina quanti utenti un modello può servire contemporaneamente e la velocità con cui ciascuno di essi riceve una risposta.
Sviluppare IA di apprendimento automatico comporta un processo noto come addestramento. In termini semplici, questo si riferisce all’apporto di dati affinché il modello possa imparare da modelli e generare output utili. Fondamentalmente, è il processo in cui il sistema risponde alle caratteristiche dei dati che gli consentono di adattare gli output verso un obiettivo cercato – che sia identificare immagini di gatti o produrre un haiku su richiesta.
L’addestramento può essere costoso perché richiede molti input, e i volumi richiesti sono in aumento – motivo per cui approcci ibridi, come il raffinamento di un modello basato su regole con dati mirati, possono aiutare a gestire i costi senza partire completamente da zero.
[See: Inferenza]
Una tecnica in cui un modello di IA precedentemente addestrato viene utilizzato come punto di partenza per lo sviluppo di un nuovo modello per un compito diverso ma tipicamente correlato – permettendo di riapplicare conoscenze acquisite in cicli di addestramento precedenti.
Il “valore” è al centro delle attività del settore tech: una crescente penuria di chip di memoria a accesso casuale, o memoria RAM, potenza la maggior parte dei prodotti tecnologici che utilizziamo nella nostra vita quotidiana. Con l’esplosione dell’industria dell’IA, le più grandi aziende tech e i laboratori di IA – tutti in competizione per avere l’IA più potente ed efficiente – stanno acquistando così tanta RAM per alimentare i loro data center che non ne rimane molto per il resto di noi. E questa stretta dell’offerta significa che ciò che rimane diventa sempre più costoso.
Questo include settori come il gaming (dove le grandi aziende hanno dovuto aumentare i prezzi delle console perché è più difficile trovare chip di memoria per i loro dispositivi), l’elettronica di consumo (dove la carenza di memoria potrebbe causare il più grande calo delle spedizioni di smartphone in più di un decennio) e l’informatica aziendale generale (perché tali aziende non riescono a ottenere abbastanza RAM per i loro data center).
Non perderti tutte le notizie di tecnologia su Blog.it